ユーザーの本音を聞き出したい。でも聞くべきことは決まっているから、雑談で終わらせたくない——そんなときに使うのが半構造化インタビューです。
定性調査の実務でもっともよく使われる形式ですが、いざ自分でインタビューガイドを作ろうとすると「質問をどこまで固定すべきか」「深掘りはどう設計するのか」で手が止まりがちです。
この記事では、半構造化インタビューの位置づけ(構造化・非構造化との使い分け)から、インタビューフローの作り方を5つのステップで整理し、そのまま使える質問例テンプレートを紹介します。
あわせて、多くの実務者がつまずく「深掘りの分岐設計は人手では回りきらない」という構造的な問題と、AIインタビューによる解決アプローチも実際の画面つきで解説します。
半構造化インタビューとは、あらかじめ質問項目(インタビューフロー)を用意しつつ、回答に応じて質問の順序変更や深掘りを許すインタビュー手法です。台本どおりに進める「構造化」と、テーマだけ決めて自由に話す「非構造化」の中間に位置します。半構造化インタビューでは、この質問項目のまとまりをインタビューフローと呼びます(インタビューガイドと表記されることもありますが、指すものは同じです)。
3つの手法の違いを整理すると次のようになります。
使い分けの目安はシンプルです。
•仮説の検証が目的で、回答を横並びで比較したい → 構造化
• テーマがまだ曖昧で、何を問うべきかから探したい → 非構造化
•仮説はあるが、その背景・理由・文脈まで知りたい → 半構造化
ユーザーインタビューや顧客ヒアリングの実務は、たいてい3つ目に当てはまります。「聞くべきことは決まっているが、想定外の話こそ聞きたい」——この両立を狙うのが半構造化インタビューであり、だからこそインタビュー設計、つまりフローの品質が結果を大きく左右します。
従業員を対象としたヒアリング等に AI インタビューを使う際の設計は「従業員サーベイで「本音」は拾えているか?」で詳しく扱っています。
インタビューフローの作り方は、次の5ステップで進めると迷いません。60分のインタビューを想定した時間配分の目安も添えます。
最初に決めるのは質問ではなく「この調査で何に答えを出すのか」です。例えば「動画配信サービスの解約者は、何をきっかけに解約を決めているのか?」のように、リサーチクエスチョンを1文で書き切ります。ここが曖昧なまま質問を並べると、聞き終わってから「で、何が分かったんだっけ」となります。
リサーチクエスチョンに答えるために必要なトピックを書き出し、must(これが聞けないと調査が成立しない)とnice-to-have(時間があれば)に分けます。半構造化インタビューは脱線を許す設計なので、時間が押したときに何を削るかを先に決めておくことが重要です。60分なら must のトピックは3〜4個が現実的です。
トピックごとに実際の質問文を書きます。このとき意識するのは3点です。
• オープン質問を基本にする
「はい/いいえ」で終わる質問ではなく、「〜について教えてください」「どんな場面で〜しましたか」と経験を語ってもらう形にする
• 誘導を避ける
「値上げが不満だったんですよね?」ではなく「解約を考え始めたきっかけを教えてください」と、こちらの仮説を言わせない言い回しにする
• 順序を設計する
答えやすいウォームアップ(5〜10分)→ 本題ブロック(40分前後)→ クロージング(5〜10分)の流れを作り、いきなり核心から入らない
半構造化インタビューの価値は深掘りで決まります。よく使う深掘りの型は次の3つです。
•なぜ: 「それはなぜですか?」「何がそう感じさせたのでしょう?」
• 具体的には: 「具体的なエピソードはありますか?」「直近ではいつでしたか?」
• 他には: 「他に理由はありますか?」「逆に良かった点は?」
さらに実務では、回答パターンごとの分岐をフローに書き込みます。
「解約理由が『サービスへの不満』なら不満の中身と強さを掘る。『引っ越しや家族構成の変化』なら生活の変化とサービス評価を分けて聞く」のように、想定される回答の型ごとに次の一手を用意しておくのです。
この分岐設計こそ半構造化の肝ですが、後述するとおり、まじめにやるほど破綻しやすい部分でもあります。
フローができたら、本番の前に社内の1〜2名で通しのリハーサル(パイロット)を行います。質問の意味が伝わるか、時間内に収まるか、深掘りの分岐が実際の回答とかみ合うかを確認し、フローを改訂します。
1回のパイロットで質問文の3割は書き直しになる、くらいの前提でスケジュールを組んでおくと安全です。
ここからは、上の5ステップを反映した質問例のテンプレートです。まず汎用の雛形、続いてシーン別の質問例を2パターン紹介します。コピーして自社のテーマに置き換えてください。
テンプレートの └回答が〜なら の行に注目してください。
解約理由そのものの調査設計(タイミング・謝礼・匿名性)は「解約理由調査のやり方」で解説しています。
これが Step 4 で説明した深掘りの分岐です。そして実は、この分岐こそが半構造化インタビュー設計の最大の難所になります。
質問例テンプレートまでで、聞く準備は整いました。ただ、半構造化インタビューが構造化インタビューと決定的に違うのは、実は聞き終わった後です。
全員に同じ選択肢を同じ順序で出す構造化インタビューなら、回答はそのまま集計できます。
一方、半構造化インタビューで手元に残るのは、人によって長さも順序も語彙も違う自由な語りです。「解約理由は?」への答えが、ある人は一言、ある人は3分の思い出話——これをそのまま足し算することはできません。だから半構造化インタビューには、集めた後に「比較できる形に変換する」工程が必ず必要になります。
その分析方法は、大きく3つの工程に分かれます。
発言録とは、録音を発言のまま文字に起こしたものです(逐語録とも呼ばれます)。
インタビュー中に取ったメモで代用したくなりますが、これは分析の精度を大きく落とします。
たとえば解約理由として、Aさんが「なんとなく高いなと思って」、Bさんが「毎月の請求メールを見るたびに引っかかっていた」と答えたとします。メモに残すと、どちらも「価格への不満」の一行になります。しかし打ち手のヒントがあるのは明らかに後者で、しかもそのヒントは「請求メールを見るたび」という言い回しの中にしかありません。
分析の単位は要約ではなく発言そのものです。だからまず発言録が要ります。
2つ目の工程は、発言録から重要な発言を拾い出して、1枚の表にまとめることです。
表側(行)に参加者、表頭(列)に調査観点を並べ、交差するセルにその人の発言を入れていきます。
解約理由デプス調査なら、列は「解約の直接のきっかけ」「解約前の視聴頻度の変化」「比較検討した他サービス」といった観点になります。
この表が埋まって初めて、参加者どうしを同じ土俵で比べられるようになります。定性調査の教科書では、発言に意味のラベルを付けていく「コーディング」という工程として説明されることもあります。
ただ、実務で先に必要なのは、ラベルを付けて数えることよりも、観点ごとに発言そのものを1か所に集めることです。打ち手のヒントは、要約やラベルではなく発言の言い回しの中に残っているからです。
難しいのは、この表を全員分そろえることです。
10人いれば10本の発言録を頭から読み、どの発言がどの列に当たるかを判断しながら書き写していきます。拾う人や読む順番によって、表に入る発言はどうしてもぶれます。
さらに、分析の途中で「解約理由ではなく、解約を思いとどまった条件で切り直したい」と気づくことがある。列を1本足すというだけのことなのに、その瞬間、10人分の発言録を最初から読み直すところからやり直しになります。
3つ目の工程は、出来上がった表を読み取ることです。
ポイントは、1人分を頭から最後まで読む(縦に読む)のではなく、観点ごとに全員の発言を横に読むこと。
「解約の直接のきっかけ」の列を10人分並べて初めて、多数派と例外が見えます。例外に見えた1人が次の打ち手につながる、というのは定性調査でよくある展開です。
KJ法でグルーピングして共通項・特徴・インサイトに分類していくのも、この工程にあたります。
KJ法はマトリクス表づくりの置き換えではなく、その後工程だと考えるのが正確です。
そして、この3工程が実務で重いのは、1と2がまるごと人手だからです。
しかもその負荷はインタビューの人数に比例して増えます。10人に増やせば発言録も10本、表への書き写しも10人分。
設計を丁寧にやって深く聞けたインタビューほど、発言録は長くなり、表を埋める作業はさらに重くなります。
いちばん頭を使うべき3つ目の工程に、いちばん時間が残らない——これが実務で起きていることです。
実は、この「人数を増やすほど成立しなくなる」という構造は、実査の側にもまったく同じ形で存在しています。
上のテンプレートでは、1つの質問につき2〜3パターンの分岐を書きました。
これを本題3ブロックすべてに用意し、さらに深掘りを2段階(回答→深掘り→その回答への深掘り)まで想定すると、分岐の組み合わせは簡単に数十通りに膨らみます。
60分×N人のインタビューで、この分岐ツリーをすべて紙のフローに書き切ることは現実的ではありません。
その結果、実務では2つの負荷がモデレーター個人に集中します。
1つ目は「判断」の負荷です。 分岐の条件は「回答者がサービスに不満を持っていそうなら」「ポジティブな反応なら」といった定性的なものです。回答を聞きながらその場で解釈し、次にどの質問へ進むかを判断する——これはフローに書けない、モデレーターの瞬発力に依存する作業です。
人によって判断がぶれ、同じ調査でもインタビュアーごとに掘れている深さが変わります。
2つ目は「深掘りの実行」の負荷です。どこまで掘るか、何と言って追い質問するかは、結局その場の言葉選びです。
経験の浅いインタビュアーは「なるほど、ありがとうございます」と流してしまい、あとで発言録を読んだ関係者が「ここ、なんで深掘りしなかったの?」と嘆く——定性調査あるあるではないでしょうか。
さらに深刻なのはスケールの壁です。熟練モデレーターが同時に実施できるインタビューは当然1件だけ。対象者を10人、20人と増やすほど日程は延び、後半のインタビューでは疲労で品質が落ち、複数人で分担すれば今度は人によるばらつきが混ざります。「分岐設計をまじめにやるほど、実施できる人が限られていく」というジレンマが、半構造化インタビューには構造的に存在します。
このジレンマに対する解決アプローチとして、弊社の AIインタビュープラットフォーム 「コルクトーク」がどう深掘りを扱っているかを、実際の画面で紹介します。
先に要点を言うと、コルクトーク は「AI が勝手にインタビューを組み立てる」のではありません。分岐はこれまで通り設計者がフローとして設計し、実査中の「判断」と「深掘りの実行」だけを AI が担う、という役割分担です。ここまで読んできたフロー設計のスキルは、そのまま活きます。
今回は例として、先ほどのテンプレート2をベースにした「動画配信サービスの解約理由デプス調査」を実際に作成しました。
設計画面のフロー全体がこちらです。

スクリーニング設問 → 対象者判定 → 解約のきっかけを聞くトーク → 解約理由の型で分岐 → 「不満の深掘り」または「状況変化の深掘り」→回答確認、という流れです。
紙のフローでは文章で書くしかなかった分岐が、ブロックのつながりとしてそのまま表現されています。
回答者と対話しながら深掘りするパートは「トーク(AI)」ブロックが担当します。
設計者が書くのは、そのブロックの目的と聞きたい質問、そして深掘りレベル(軽め/普通/深め)だけです。

「なぜ」「具体的には」「他には」といった追い質問の一つひとつを書き出す必要はありません。どこまで掘るかの深さをレベルで指定すれば、その範囲で AI が文脈に合わせた追い質問を行います。
回答者が特定のサービス名や人物に言及した場合に具体名を聞き出すオプションも、チェックボックス1つで設定できます。
分岐そのものは、設計者が分岐ブロックで明示的に設計します。
選択式の回答(「解約経験あり/なし」など)は通常の条件で決定論的に分岐できますが、コルクトーク の特長は直前の会話内容そのものを条件にできることです。

今回の調査では「回答者が料金・コンテンツ・使い勝手などサービス自体への不満を理由に解約を考えたと判断できるか判定してください」という条件を LLM 条件として設定しました。
実査中はこの判定を AI が行い、true なら「不満の深掘り」へ、そうでなければ「状況変化の深掘り」へ進みます。判定できなかった場合にどちらへ倒すか(フォールバック)も指定できるため、挙動は常に決定的です。
つまり、モデレーターの頭の中にしかなかった「この人は不満型か、環境変化型か」という実査中の判断が、設計時に書ける明文化された条件になるということです。判断基準が明文化されるので、10人実施しても100人実施しても同じ基準で分岐します。
このインタビューに、筆者が1人の回答者として実際に答えてみました。「不満の深掘り」ブロックで「一番の不満は値上げ。
子どもが生まれて視聴時間が取れなくなり、月1,480円を払う価値を感じられなくなった」と答えたところ、AI は次のように返してきました。

参加者の回答画面。値上げへの不満を答えた参加者に対し、AI が視聴タイミングを尋ねる追い質問を返している
「お子さまが生まれて視聴時間が減ったとのことですが、普段はどんなタイミングでサービスをご覧になっていたんでしょうか」
——この質問はフローのどこにも書いていません。回答の中の「子どもが生まれて」という文脈を拾って、利用シーンを特定しにいく追い質問を AI がその場で組み立てています。設計者がやったのは、深掘りレベルを「深め」にしたことだけです。
実施後の管理画面では、セッションごとに「どの分岐が、どの条件で、どう判定されたか」まで確認できます。

人間のモデレーターの頭の中で行われていた判断はあとから検証できませんが、ここでは「解約理由の型で分岐」ブロックが条件にマッチして「不満の深掘り」へ遷移したことが記録されています。
判断の透明性という点で、人手のインタビューでは得られなかった情報です。
やり取りの全文も、ブロックの区切りごとにタイムスタンプ付きの文字起こしとして残ります。

そして AIインタビューは同時に何セッションでも走ります。「分岐設計をまじめにやるほど実施できる人が限られる」というジレンマは、設計はこれまで以上にまじめにやり、実行だけを AI に任せることで解消できるわけです。
従来手法とのコスト比較は、関連記事「デプスインタビューの費用相場と期間」で詳しく解説しています。
デプスインタビュー自体の進め方は「デプスインタビューとは?やり方・質問例・費用まで実務で使える完全ガイド」で整理しています。
ここまでは実査中の「判断」と「深掘り」の話でした。
最後に、実施した後の分析を見ておきます。
前半で整理した3工程(発言録 → マトリクス表 → 読み取り)のうち、コルクトークが引き受けるのは1と2です。
3つ目の読み取りは人の仕事のまま残ります。というより、そこに時間を寄せるための機能だと考えてください。
1つ目の工程は、実質的に消えます。
前節で見たとおり、やり取りの全文はブロックの区切りごとにタイムスタンプ付きの文字起こしとして自動的に残るためです。書き起こしの外注も、聞き直しも発生しません。
さらに、参加者ごとの回答画面には「文字起こし」タブと並んで「回答」タブがあり、その中に質問ブロックごとの「質問ごとのまとめ」が表示されます。
ここには、インタビュー中に AI が質問単位で作った要約が入っています。つまり全文の発言録と、質問単位に切り分けられた要約が、実施完了と同時に両方そろっている状態です。
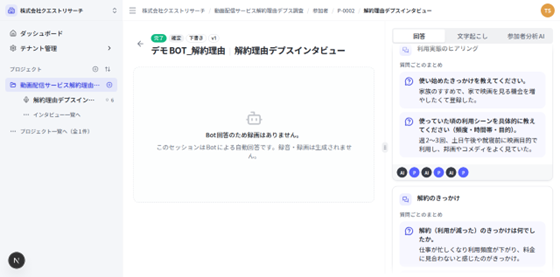
なお、この要約は「あとから AI にまとめさせたもの」ではなく、実査中に会話の文脈を持ったまま作られたものです。深掘りで引き出した内容も、この時点で質問に紐づいています。
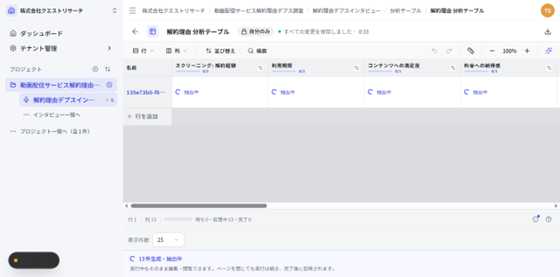
2つ目の工程は、プロジェクトの「高度な分析」(インタビュー単位で見る場合は「分析テーブル」)で行います。
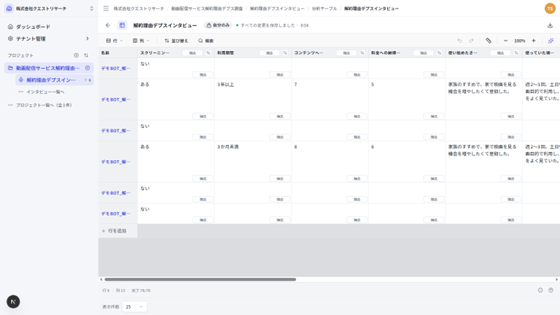
分析テーブルは、行が参加者、列が観点のスプレッドシートです。前半で説明した、参加者×観点のマトリクス表そのものだと考えてください。
作り方は2通りあります。
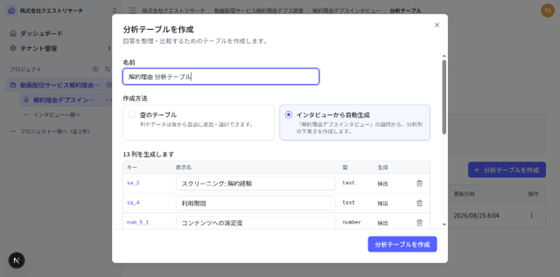
空のテーブルから設計することもできますが、実務でよく使うのは「インタビューから自動生成」です。
対象のインタビューを選ぶと、その設問から列の下書きが自動で作られます。設問1つにつき1列、という初期状態が最初から用意されるわけです。
分析の枠組みをゼロから設計しなくてよい、というのがここでの効きどころです。「何を列にするか」で手が止まる時間が、そのまま消えます。
列には3つの種類があります。
このうち AI生成列が、表のセルを埋める部分にあたります。
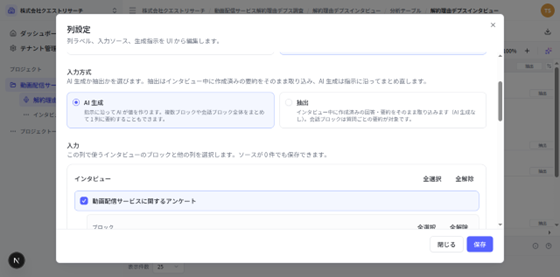
列設定パネルで、入力に使うインタビューとブロック(あるいは他の列)を選び、生成指示を日本語で書きます。
解約理由デプス調査なら、たとえばこう書きます。
解約の直接のきっかけを「値上げ」「コンテンツ不足」「視聴時間の減少」「他サービスへの移行」のいずれかに分類し、根拠になった発言を1文添えてください。
手で表を埋めるのとの違いは2点あります。
1つは、同じ生成指示が全参加者に一律に適用されること。誰がどの発言を拾うかで表の中身がぶれる、ということが起きません。
もう1つは、やり直しがきくことです。「解約理由ではなく、解約を思いとどまった条件で切り直したい」と気づいたら、列を足して生成指示を書き換え、もう一度実行すれば済みます。
全員分の発言録を読み直す必要はありません。10人でも100人でも、手間は同じです。
生成は裏側で走ります。参加者の行を追加すると、その場で生成・抽出が自動的に始まり、下部のトレイに進捗件数が表示されます。実行中もテーブルの閲覧・編集は続けられ、ページを閉じても処理は進みます。
3つ目の工程には、表が埋まった時点で入れます。
行が参加者、列が観点になっているので、観点ごとに縦の列を見ていけば、多数派と例外がそのまま並びます。
参加者名や参加者番号での検索、列の値での並び替えもできるので、「他サービスへの移行と分類された人だけ」を上に集めて読む、といった読み方ができます。
複数のインタビューを1枚のテーブルに載せることもできます。列ごとに参照元のインタビューを指定できるため、たとえば第1波と第2波を並べて、同じ観点で変化を見る、といった使い方が可能です。
社内の共有や既存のレポートフォーマットに合わせたい場合は、CSV でエクスポートできます。
文字コードは UTF-8 と Shift-JIS を選べるので、Windows 版 Excel でそのまま開きたい場合は後者を選びます。
KJ法で発散させたい場合も、この段階から始められます。
分析テーブルは KJ法の置き換えではなく、その手前にある「発言を1枚の表に集める」工程を自動化するものだと考えると、位置づけがはっきりします。
手を動かす価値があるのは、表が埋まった後の読み取りのほうです。発言録の書き起こしと表への書き写しに使っていた時間を、そこに寄せられるということです。
最後に、この記事の要点を4行でまとめます。
質問例テンプレートはそのままコピーして使えるように書きました。まずは自社のテーマで1本、インタビューフローを設計してみてください。
そして「この分岐、人手で回るだろうか」「10人分の発言録を誰が読むんだろう」と感じたら、AI インタビューを試すタイミングです。
コルクトークなら、この記事で見たとおり設計画面でフローを組み、URL を配るだけで24時間・複数名同時のインタビューが動き、終わった時点で発言録と分析テーブルの素材までそろいます。
従来手法とのコスト比較は、関連記事「デプスインタビューの費用相場と期間」で詳しく解説しています。